FPT và Nvidia mở rộng dữ liệu mô phỏng 1 triệu người Việt để phát triển AI

FPT và Nvidia vừa mở rộng bộ dữ liệu Nemotron-Personas-Vietnam lên quy mô 1 triệu hồ sơ người dùng giả lập, tăng gấp 10 lần so với phiên bản 100.000 hồ sơ được giới thiệu trước đó. Bộ dữ liệu được công bố miễn phí trên nền tảng Hugging Face, phục vụ cộng đồng nghiên cứu và phát triển trí tuệ nhân tạo (AI).
Dự án được phát triển với sự tham gia của Nvidia và Viện Quantum AI & Cyber Security (QACI) thuộc Tập đoàn FPT. Dữ liệu được xây dựng dựa trên các nguồn thống kê chính thức về dân số, lao động Việt Nam, kết hợp phương pháp tạo dữ liệu tổng hợp Nemotron-Personas của Nvidia. Giao diện bộ dữ liệu của Nvidia trên Hugging Face, hiển thị 1 triệu hồ sơ giả lập cùng các trường mô tả đặc điểm người dùng ẢNH: CHỤP MÀN HÌNH HUGGINGFACE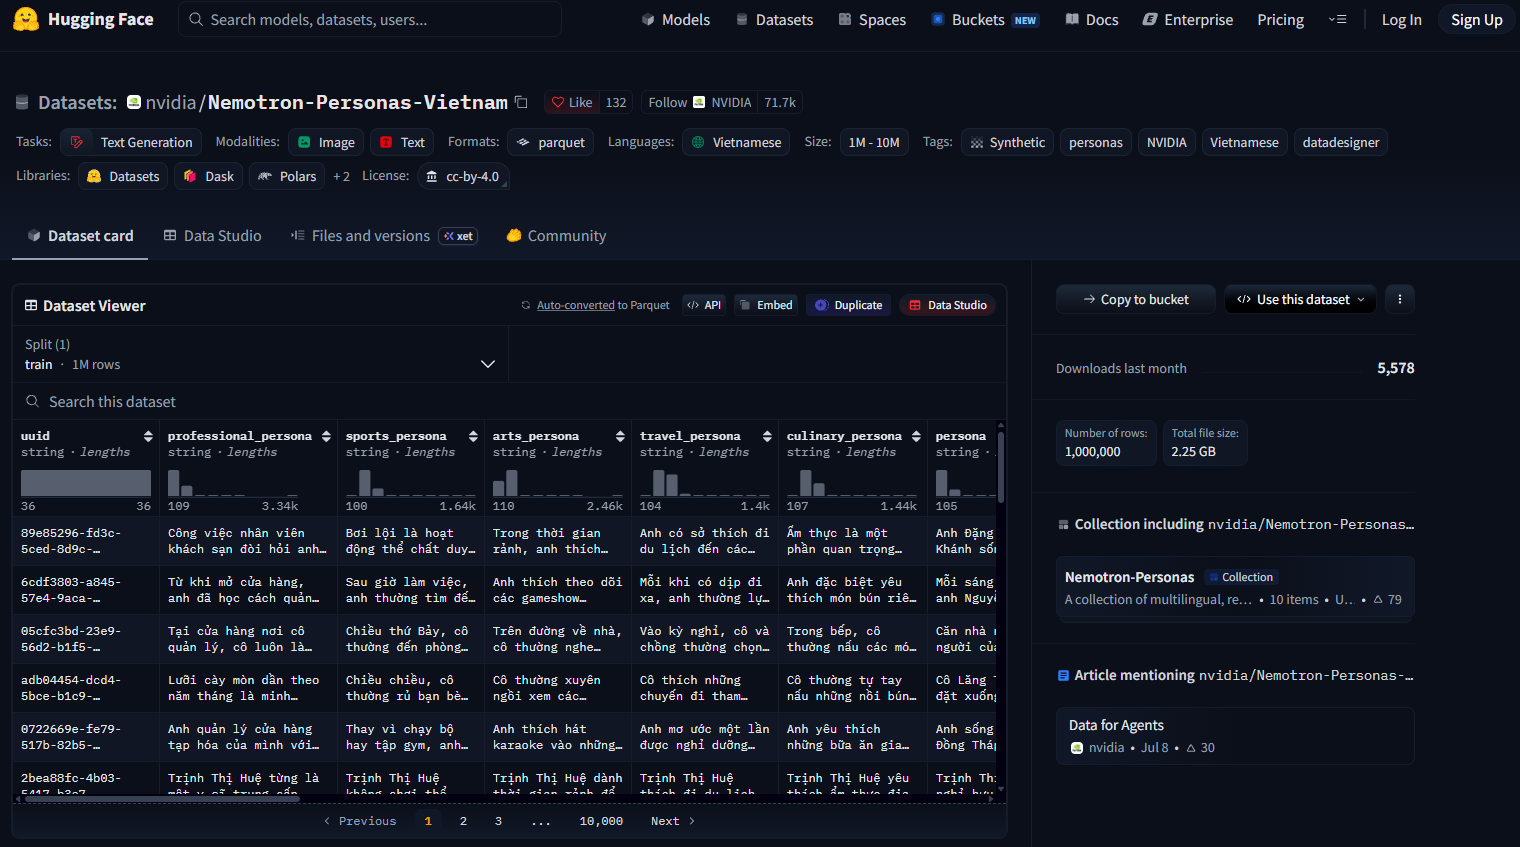
Điểm khác biệt của Nemotron-Personas-Vietnam là khả năng mô phỏng nhiều nhóm người dùng với đặc điểm nhân khẩu học và hoàn cảnh sống khác nhau. Mỗi hồ sơ gồm 21 trường thông tin, trong đó có 6 trường mô tả đặc điểm cá nhân và 15 trường phản ánh bối cảnh liên quan.
Các thuộc tính được mô phỏng bao gồm giới tính, độ tuổi, tình trạng hôn nhân, trình độ học vấn, nghề nghiệp và khu vực cư trú. Phiên bản mở rộng cũng tăng phạm vi bao phủ trên toàn quốc, giúp tạo ra nhiều tình huống sử dụng AI phù hợp với đặc điểm dân số Việt Nam.
Dữ liệu giả lập hỗ trợ phát triển và kiểm thử AI
Bộ dữ liệu có thể được sử dụng để xây dựng các nhóm người dùng giả lập, qua đó kiểm thử khả năng phản hồi của chatbot, mô hình ngôn ngữ lớn (LLM) và các tác nhân AI (AI Agent) trong nhiều tình huống khác nhau.
Chẳng hạn, nhà phát triển có thể tạo các kịch bản tương tác với người dùng thuộc nhiều nhóm tuổi, ngành nghề hoặc khu vực cư trú để đánh giá mức độ phù hợp của hệ thống AI. Dữ liệu cũng hỗ trợ kiểm tra thiên lệch trong phản hồi giữa các nhóm nhân khẩu học, phục vụ quá trình điều chỉnh và đánh giá mô hình.
Một yếu tố quan trọng là toàn bộ hồ sơ đều được tạo tổng hợp, không phải thông tin thu thập từ 1 triệu cá nhân có thật. Theo mô tả của dự án, bộ dữ liệu không chứa thông tin định danh cá nhân, giúp các đơn vị phát triển AI có thêm nguồn dữ liệu thử nghiệm mà không cần sử dụng trực tiếp hồ sơ khách hàng.
Bộ dữ liệu hiện được cung cấp trên Hugging Face với giấy phép CC BY 4.0, cho phép sử dụng và chia sẻ theo các điều kiện đi kèm. Tuy nhiên, những hồ sơ giả lập không phản ánh chính xác tính cách hay hành vi thực tế của từng người Việt Nam.
Thay vì đại diện cho những cá nhân cụ thể, các hồ sơ này được dùng để xây dựng kịch bản tương tác đa dạng, hỗ trợ kiểm tra cách AI phản hồi trước những nhóm người dùng khác nhau. Qua đó, các nhà phát triển có thêm công cụ để đánh giá và điều chỉnh hệ thống AI theo đặc điểm sử dụng tại Việt Nam.
Theo Thanh Niên


